Varning vs prediktion
I sin
ursprungsartikel den 14 augusti gör Berglund et al stor sak av att jag
ett par år tidigare i samma tidning skrivit att vi "inte [kan] ta för givet att vi överlever en otillräckligt säkrad GPT-5", och menar att det faktum att vi trots att GPT-5 släpptes tidigare denna månad ännu är i liv visar att mina varningsord var "förhastade och missriktade". Jag valde att inte säga något i min replik om denna sammanblandning mellan risk och prediktion eftersom utrymmet var begränsat och jag bedömde den vara så urbota dum att det vore onödigt att skriva just detta argumentationsfel
Ny Tekniks läsare på näsan. Troligen har dock andra personer hört av sig till författarkvartetten angående detta argumentationsfel, då de uppenbarligen känner sig manade att i sin slutreplik försvara denna argumentation. De kallar det "erbarmligt svagt" att insistera på denna disktinktion och menar att yttrandet av mina varningsord är analogt med att hävda att vi
inte [kan] utesluta att Gud kommer att straffa Sverige som ett resultat av kyrkflytten i Kiruna, och denna fråga är extremt akut!1
Jag gratulerar Berglund et al till att ha kommit på denna färgstarka metafor. Låt mig föreslå en alternativ metafor.
En femåring korsar en bilväg medelst metoden att hålla för ögonen och rusa i full fart rakt fram. Berglund får syn på detta, och blir så förskräckt att han griper tag om femåringen och meddelar att metoden är livsfarlig eftersom han (femåringen) kan bli överkörd. Femåringen sliter sig ur Berglunds grepp, och rusar blint tillbaka till den ursprungliga sidan av vägen samt ropar triumferande att Berglunds varningsord var "förhastade och missriktade" i och med att passagen gick bra och inte medförde någon bilolycka.
Skillnaden mellan kyrkflytten och bilvägspassagen ligger naturligtvis i graden av rimlighet: i kyrflyttsfallet varnas för ett långsökt och konstlat och rent ut sagt orimligt scenario utan stöd i någon som helst evidens, medan varningen i bilvägspassagefallet rör ett med tanke på evidensläget ytterst rimligt scenario. Så hur skall man då bedöma mina varningsord från 2023? Det hela kokar ned till om det scenario jag varnade för var rimligt. Jag anser att det var rimligt (och därför mer liknar bilvägspassageexemplet) medan Berglund et al anser att det var orimligt. Det är denna orimlighet de behöver påvisa istället för att i generella ordalag döma ut distinktionen mellan varning och prediktion. Tyvärr är det tunnsått i deras debattinlägg med konkret sådan argumentation.
Spekulation vs vetenskap
Berglund et al verkar tro att luddigheten i deras argumentation för att någon risk för AI-katastrof inte föreligger på något sätt trollas bort genom att de tillräckligt många gånger upprepar att deras påstående grundar sig i vetenskaplig empiri. Exakt vari denna empiri består förblir något oklart, och än mer hur den leder till deras tvärsäkra slutsats. Samtidigt säger de i dagens slutreplik att min argumentation "primärt [vilar] på abstrakta, spekulativa tankeexperiment och påminner mer om science fiction än vetenskap". Här får man faktiskt glädjas en smula åt ordet "primärt", som möjligen kan förstås som en uppmjukning jämfört med ursprungsartikeln - sedan jag i min replik länkat till
METR och
AI 2027 kan de inte längre med att hävda att argumentationen hos oss som tar existentiell AI-risk på allvar är fri från empiri. Det är i så fall ett framsteg, men de borde då inse att vad som behöver göras är att väga de olika empiriska underlagen mot varandra. I stället fortsätter de hojta om science fiction, som om det faktum att datalogiforskningen var så mycket trögare än Hollywood med att reagera på
Alan Turings ödesmättade ord från 1951 om att
"at some stage [...]
we should have to expect the machines to take control" på något vis skulle implicera att existentiell AI-risk inte är på riktigt.
Bida sin tid
En potentiell svårighet med att säkra avancerad AI mot att ha farliga förmågor och böjelser är att en tillräckligt avancerad AI kan välja att mörka dessa och bida sin tid tills dess den blivit ännu mer kraftfull eller på annat vis hamnat i ett bättre läge att skrida till handling. Fullständigt orimligt att så skulle kunna ske, tycker Berglund et al, men eftersom jag i min replik i
Ny Teknik länkar till en
Anthropic-studie som påvisar empiriskt att redan dagens AI har viss förmåga till sådant rävspel, så kan de inte låtsas okunniga om denna evidens. Istället för att förneka den spekulerar(!) de om denna förmåga möjligen kan bero på att liknande scenarier finns i den science fiction-litteratur som ingår i AI:s träningsdata. Därmed gills det inte, tycks de mena. Men AI:s förmågor är vad de är, oavsett om Berglunds et al spekulation stämmer eller inte. Att förklara ett fenomen är inte liktydigt med att påvisa att det inte finns.
Brist på konsensus
Berglund et al skriver i dagens inlägg att det "finns verkligen ingen konsensus i fältet om att uppskalning av dagens AI-modeller skulle leda till vare sig AGI [...] eller än mindre till uppkomsten av AI med plötsliga, okontrollerbara förmågor". Jag känner såklart till detta. Vissa forskare anser AGI vara inom nära räckhåll medan andra lutar åt motsatt slutsats. Inte heller jag känner mig tillnärmelsevis säker i denna fråga, och inget i min argumentation för att ta existentiell AI-risk på allvar bygger på någon tvärsäkerhet om vad som kommer att hända. Men till skillnad från Berglund et al menar jag att en sådan brist på konsensus ger anledning till ödmjukhet och försiktighet snarare än till slutsatsen att risken är noll.
Ad hominem
"Jag är AI-forskare, jag har god teknisk kunskap", kände sig Moa Johansson manad att framhålla i onsdagens radiodebatt, och i dagens Ny Teknik-artikel återkommer hon och hennes medförfattare med viss pompa till hur kompetenta de minsann är. Men medan Johansson i radioinslaget stannade vi det och lät påståendet att jag saknar denna kompetens förbli underförstått, så går de i artikeln vidare och hävdar att "Häggström följer [...] inte den tekniska litteraturen" inom AI. Även om vi för resonemanget skull antog att påståendet är sant, så uppstår frågan: hur tusan vet de vilken litteratur jag följer eller inte följer? Det här är rent hittepå från Berglund et als sida.
Vart vill de då komma med detta? Jo, de ansluter sig till medförfattaren Devdatt Dubhashis uppfattning att den enda kompetens som räknas inom AI är den där man "bidrar aktivt till den tekniska AI-utvecklingen". Dubhashi har i snart tio år kampanjat (till en början i direkt konfrontation med mig, men på senare år mestadels bakom min rygg) för att jag bör hålla truten eller i annat fall inte lyssnas på eller erbjudas diverse plattformar, med hänvisning till att jag inte uppfyller hans ytterst specifika krav på vad som är verklig AI-kompetens. Kompetens inom områden som AI-risk och AI-futurologi räknas inte - faktiskt inte ens i diskussioner som (likt denna) handlar om just dessa områden.
Förlåt min franska, men jag finner det direkt fåraktigt av Berglund et al att driva denna argumentation, och det av två skäl. För det första är den analog med den (förhoppningvis uppenbart!) flänga idén att man i diskussioner om låt oss säga jordbrukets framtid skulle behöva vara bonde för att förtjäna att tas på allvar. För det andra är den linje jag här driver i stora drag densamma som den Geoffrey Hinton förfäktar, så för att Berglund et als ad hominem-attack skall fungera så behöver de påvisa att inte heller Hinton "bidrar aktivt till den tekniska AI-utvecklingen". Nog för att Berglund et al hävdat många konstiga saker, men en fullt så flagrant felaktighet tror jag inte att de vill försvara.
Nåväl, gör då inte jag mig skyldig till motsvarande ad hominem-argumentation då jag i min Ny Teknik-replik kommenterar en dumhet i Berglund et als ursprungsartikel med att "allt de därmed påvisar är den egna okunnigheten om AI-risklitteraturen"? Nej, jag tycker inte det, eftersom det jag skriver uppenbart är tänkt inte som en kommentar om dem som personer, utan om felen i deras artikel. Nu påstår de att "i motsats till vad Häggström tror är vi bekanta även med [AI-risk-litteraturen]". Jaha minsann. Hur skall man då förklara att Johansson i radioinslaget upprepade gånger ger uttryck för föreställningen att AI-risk-litteraturen kopplar existentiell AI-risk till fenomenet medvetande, eller att de i sin ursprungsartikel för ett resonemang som förbiser "bida sin tid"-fenomenet (se ovan), eller deras ständiga påståenden om att denna litteratur är fri från empiri? Jag trodde faktiskt att jag gav dem the benefit of the doubt genom antagandet att dessa exempel bottnade i bristande bekantskap med litteraturen ifråga, men om vi skall ta på allvar deras insisterande på att de faktiskt besitter denna bekantskap, då blir slutsatsen istället att de låtsas okunniga för att lättare kunna göra sina retoriska poänger. Eller med andra ord, de narras!
Skrämselpropaganda
Redan 2023 anklagade Dubhashi och Johansson (i en lite annan författarkonstellation) mig för "skrämselpropaganda", ett ord som återkommer i båda deras nu aktuella
Ny Teknik-artiklar. I den sista av dessa varierar de också sitt språkbruk en smula och talar även om "alarmism".
Very well. Den situation vi (mänskligheten) befinner oss i med anledning av den framrusande AI-utvecklingen är ohyggligt skrämmande. Om det räknas som "skrämselpropaganda" att tala klarspråk om detta - må så vara. Vad Berglund et al dock bör vara medvetna om är att de med den sortens okvädningsord bidrar till ett samtalsklimat där det blir svårare för forskare som tycker sig se stora samhällsfaror på något område att slå larm.
Sammanfattning
Diskussionen i Berglunds et al ursprungsartikel den 14 augusti var på en nivå som jag inte tycker borde anstå universitetsforskare, och den blev knappast särskilt mycket bättre i dagens slutreplik. I min replik den 15 augusti avslutade jag med en släng om hur genant det var att arbeta vid samma lärosäte som en grupp forskare som tillåter sig denna nivå. Det står jag fast vid, men det är egentligen inte det som är det riktigt allvarliga. Det riktigt allvarliga är att de genom sin desinformtionskampanj försvårar uppkomsten av den breda och samtidigt rationella och faktabaserade publika diskussion om AI-risk som vi så väl behöver om vi skall kunna sätta stopp för den extremt farliga utveckling som nu pågår.
Fotnot
1) Kyrkflytten färdigställdes igår, och deras text verkar vara författad dessförinnan.
Tillägg 27 augusti 2025:
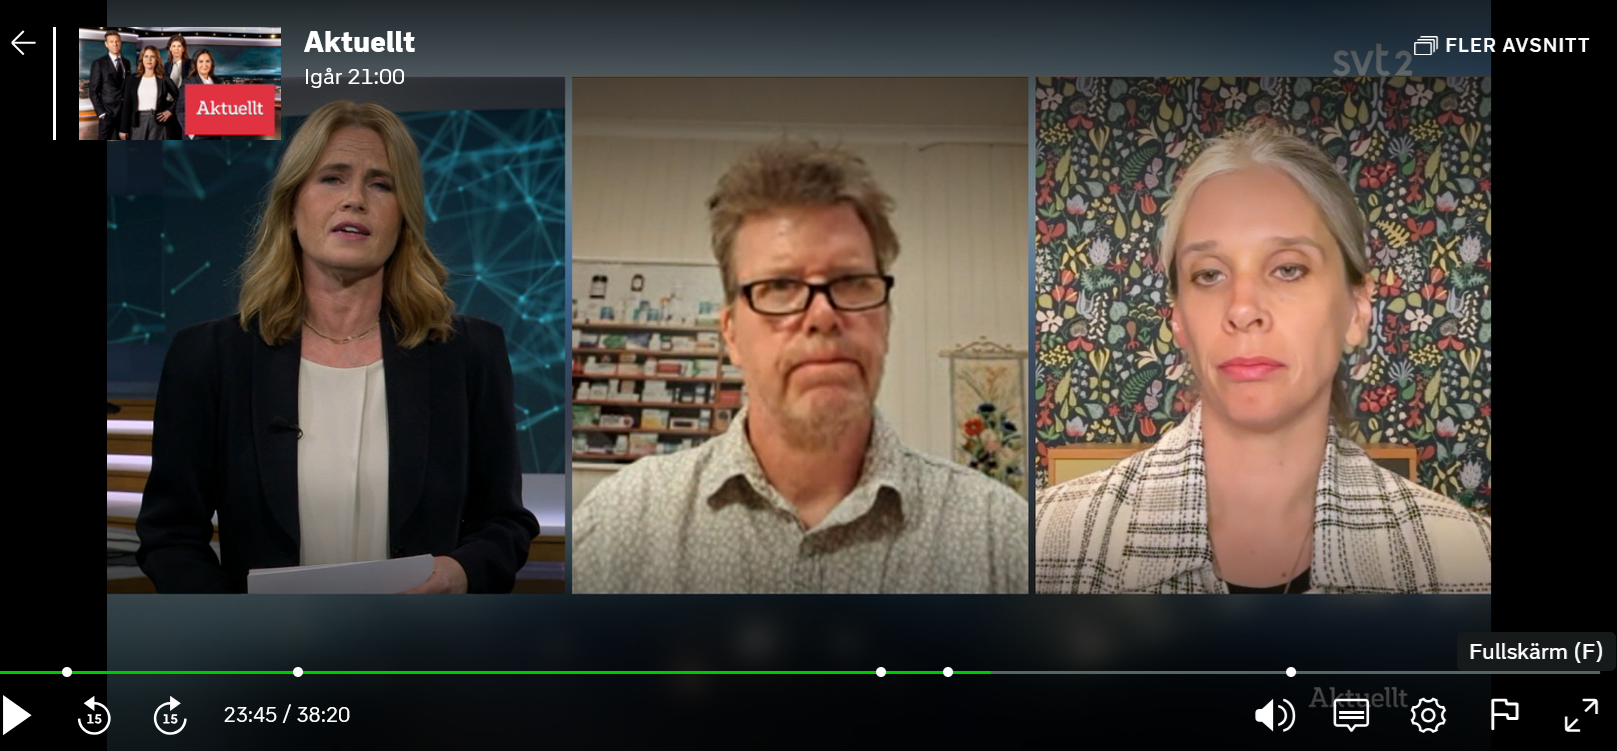
Igår, den 26 augusti, fich jag möta Moa Johansson ännu en gång, denna gång i SVT:s
Aktuellt (med start ca 22:40 in i sändningen). Jag kan inte tänka mig annat än att hon som en del av sina förberedelser läst denna bloggpost, men hennes inlärningskurva
2 förefaller dessvärre ganska platt, då hon i sändningen upprepade såväl sitt svepande och felaktiga påstående om bristen på empiri inom AI-riskforskningen som det bisarra argument jag diskuterar i avsnittet
Bida sin tid ovan.
Chalmersandan!
Fotnot tillagd den 24 september 2025
2) Det har kommit till min kännedom att det i interna Chalmersdiskussioner förekommit illvilliga tolkningar som går ut på att mitt tal om "inlärningskurva" skulle vara en antydan om att Moa Johansson är ointelligent. Detta vill jag å det bestämdaste tillbakavisa.
Jag anser inte att Moa Johansson är ointelligent, och skulle aldrig komma på tanken att kalla henne det. Att kalla en Chalmerskollega ointelligent vore inte bara tölpaktigt och dålig ton, utan vore i detta fall rent ut sagt dumt: Min linje gentemot de fyra Chalmerskollegorna i den aktuella debatten har konsekvent varit att peka på hur intellektuellt ohederligt de debatterar, och att klandra dem för detta. Ohederlighet har inget med ointelligens att göra, så att mitt i den debtten plötsligt anklaga någon av dem för ointelligens vore en irrelevant och föga ändamålsenlig avvikelse från ämnet. Och det har jag mycket riktigt inte gjort.
Intrycket att en "inlärningskurva förefaller [...] ganska platt" (för att nu citera vad jag skriver ovan) kan uppstå på flera olika sätt, varav två är (a) att personen vars inlärningskurva det handlar om är ointelligent, och (b) att den nya kunskap det handlar om av något skäl är obekväm för personen ifråga, som därför inte låtsas om den. Att någon av de fyra kollegorna, eller någon av deras fans, vill framställa mig i så negativ dager som möjligt och därför väljer tolkning (a) är måhända inget att förvåna sig över. Men ingen som på allvar skärskådar den aktuella passagen, och zoomar ut lite och tar in kontexten, kan rimligtvis missa att det givetvis är (b) jag avser. Och om jag nu skall vara övertydlig och explicit skriva ut allt som står mellan raderna där, så blir det ungefär
Moa Johansson uppvisar med sina SVT-uttalanden en platt inlärningskurva. Vad kan det bero på? Det kan knappast handla om ointelligens - hon är ju trots allt docent i datavetenskap vid ett av Sveriges ledande lärosäten - så uppenbarligen beror plattheten på att hon inte vill låtsas om den nya kunskapen att hennes argument från Ny Teknik visat sig vara felaktiga.
Ett lite kortare sätt att uttrycka samma sak och som inte heller tillskriver henne ointelligens vore att säga "Spela inte dum!".
